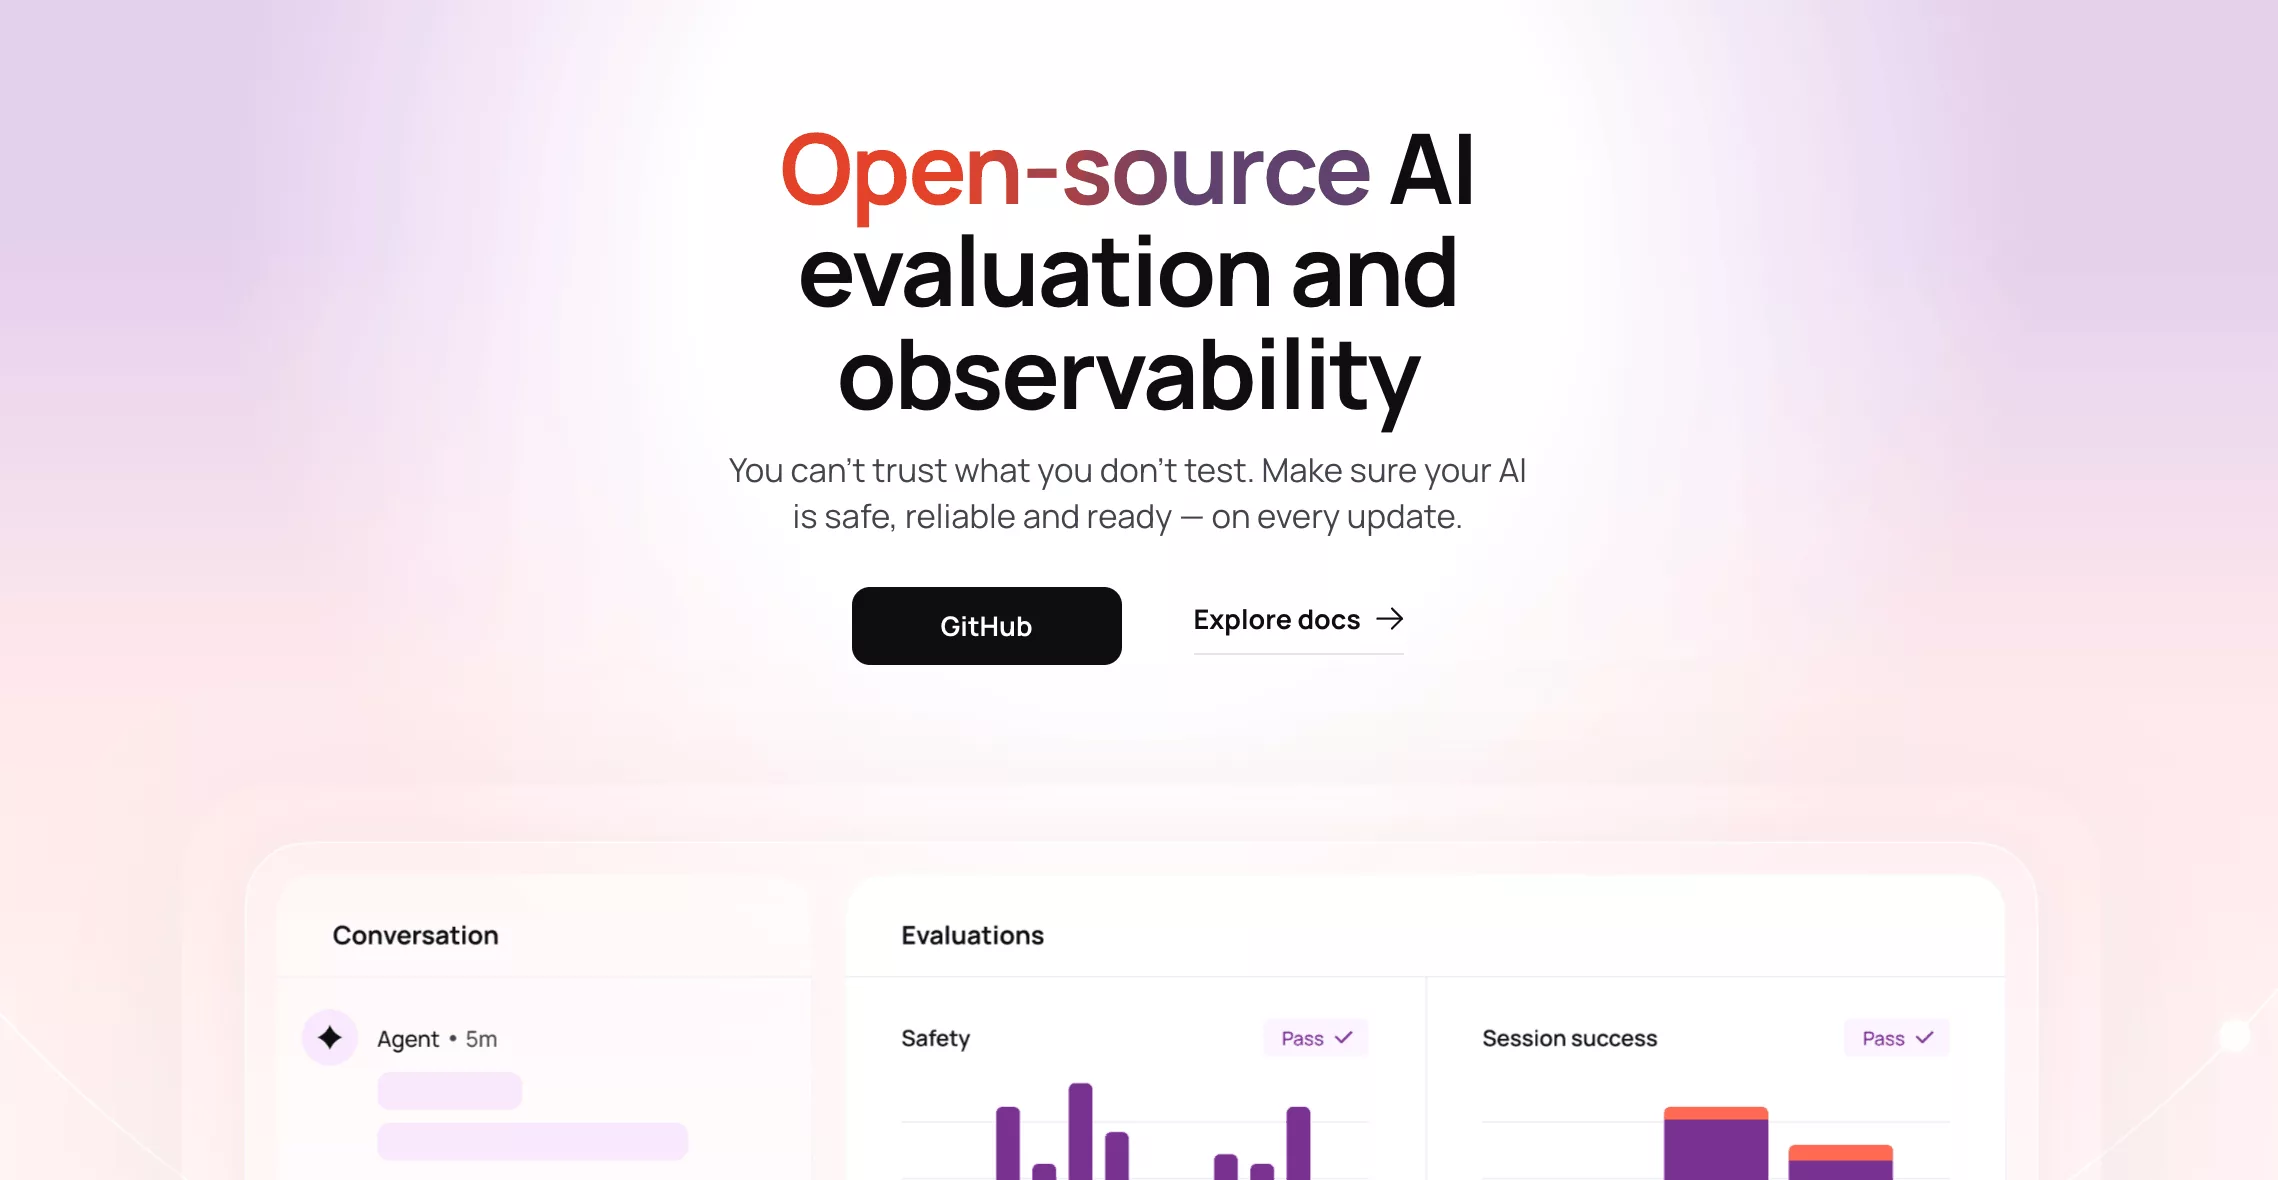
Evidently 是 Evidently AI 推出的开源框架,专注为 AI 系统做评测、观测与漂移监控,采用 Apache 2.0 许可,代码托管在 GitHub 上。首页那句 You can't trust what you don't test 点明了它的做事方式:先测,再谈信任。产品分两条主线,一条面向大模型与 AI 智能体,评估回答质量与安全表现;另一条面向预测类机器学习系统,持续观察数据漂移与预测质量。无论你只想跑一次离线评测,还是要把质量检查接进日常发布流程,都能从这套开源工具起步。官方文档、用例库与社区资源同样公开,装好之后就能直接跑通示例。
📊
把常见失败整理成排查清单
AI 出错的方式和传统软件不一样,官网专门把失败类型列成清单:幻觉、边缘输入带来的质量下滑、敏感信息泄漏、危险输出、越狱攻击、数据漂移,两组一共十二类,几乎覆盖日常能遇到的翻车场景。做质检时可以按这份清单逐项排查,不必每次从零想问题。配合官网提供的 LLM 当评委完整指南电子书,团队能更快搭起一套可复用的评分标准,把零散的主观印象变成可以反复执行的检查项。清单之外,安全与质量两条线各有侧重,读者可以按团队当前的短板挑选先做的部分。
🛡
盯住数据漂移与安全风险
预测类系统最怕数据悄悄变化:线上数据和训练时分布不一致,模型表现就会下滑,Predictive ML Systems 这条产品线正是为此而设,持续跟踪数据漂移与预测质量,让团队在指标异常时及时发现。安全侧同样有对应能力,敏感信息泄漏、越狱攻击、危险输出都可以纳入检查范围,适合上线前做回归,也适合日常运行中持续巡检。对数据科学和 AI 安全岗来说,一套工具同时覆盖质量与安全,省去了在多个系统之间来回切换的麻烦。把漂移和安全放进同一个框架,指标异常时不用换工具再查第二遍。
官网首页最显眼的位置留给了 You can't trust what you don't test,中文就是没测过就别轻信。多数工具会先讲自己能做什么,这里先把为什么要做讲在前面,提醒团队每次更新模型或提示词之后都要重新确认 AI 是否安全可靠。这种写法会改变使用心态:评估不是上线前的一次性动作,而是每次改动之后都要走的环节。
 Evidently